


10 分钟了解 SRAM、L1 Cache、L2 Cache
885 字
4 分钟
10 分钟了解 SRAM、L1 Cache、L2 Cache
本文只是笔者学习之后的思考,不足为道,如果可以,但愿能给你带来点收获。
Q1:SRAM 这个词我觉得好陌生,我之前听的最多是 HBM、Shared Memory、寄存器,它们之间的联系区别是什么?
SRAM (Static Random Access Memory) 是一种半导体存储工艺(静态随机存取存储器),速度快但密度低、贵。
它是硬件层面上的概念,不同于 HBM、Shared Memory、寄存器这些编程模型中的逻辑抽象。
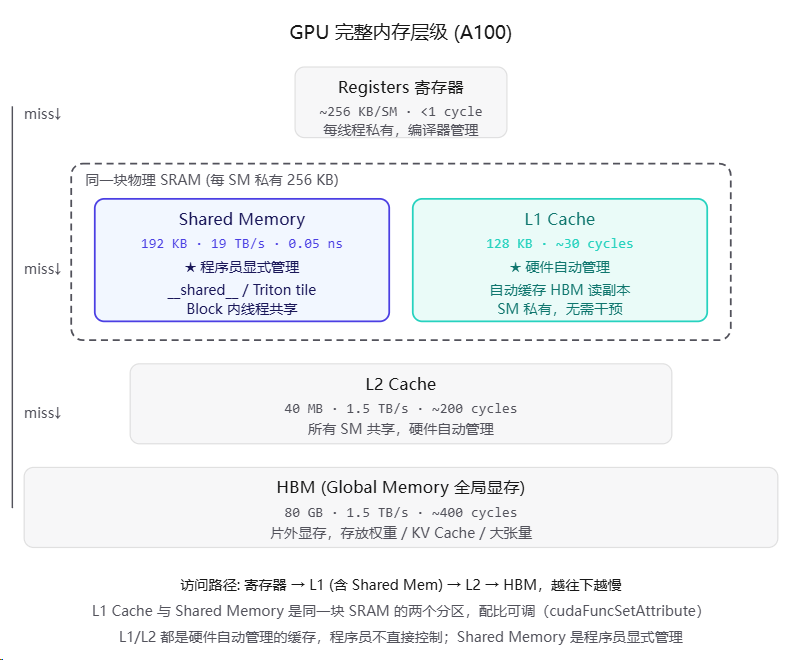
GPU 芯片├── SM 0 → 自带一块 SRAM (192 KB) → 这个 SM 内的线程共享 ← 这就是该 SM 的 Shared Memory├── SM 1 → 自带一块 SRAM (192 KB) → 这个 SM 内的线程共享├── SM 2 → 自带一块 SRAM (192 KB) → ...│ ... (A100 有 108 个 SM)└── SM 107→ 自带一块 SRAM (192 KB) ↓ 所有 SM 共享 L2 Cache (40 MB) ↓ HBM (80 GB,片外)从这个结构知,每个 SM 内部有一块独立的 SRAM,每 SM 的 SRAM 可配成 shared mem + L1。Shared Memory 是 SM 私有的 SRAM 切片。
A100 默认:192 KB shared memory + 128 KB L1 cache(同一块 SRAM 上)。
Q2:L1 cache 又是什么?有什么用?和其他几个概念的联系是什么?
L1 Cache 和 Shared Memory 物理上是同一块 SRAM 的两个分区,只是管理权限不同。
SM 内部的一块 SRAM (A100: 192 KB shared + 128 KB L1 = 256 KB 总量)├── Shared Memory (192 KB) ← 程序员显式管理└── L1 Cache (128 KB) ← 硬件自动管理L1 Cache 的实际作用(有点超纲了,小白可跳过知道是啥就行了)
- 自动缓存寄存器溢出:线程寄存器不够用时数据会 spill 到 L1(叫 local memory),比直接去 HBM 快。
- 自动缓存全局内存读:同一个 SM 的多个线程读同一地址时,L1 命中可避免重复走 HBM。
- 间接优化算子:好的访问模式能让 L1 命中率高,差的模式(如随机跳读)会让 L1 失效,性能掉到 HBM 带宽。
Q3:L2 cache 是什么?有什么用?和其他几个概念的联系是什么?
L2 Cache 也是片上缓存(也就是 SRAM 工艺),但它是所有 SM 共享的,用作 HBM 读写的缓冲,由硬件自动管理,程序员一般不直接控制。也就是 L2 Cache 相当于 HBM 的”前置缓存”。当 SM 要读 HBM 里的数据时,数据会先被搬到 L2,下次同样的数据再被读到时,就能直接从 L2 拿,不用再走慢吞吞的 HBM。
L2 Cache 怎么工作
当 SM 要读 HBM 里某个数据时,硬件自动走这条链:
- 先查 L2:如果数据在 L2 里有副本(命中 hit),直接从 L2 取走(1.5 TB/s,不用去 HBM)。
- L2 没命中(miss):穿透到 HBM 取数据。
- 取回来的同时:数据会被复制一份留在 L2 里。
- 下次再读同一块数据:直接命中 L2,省掉一次 HBM 往返。
L2 vs SRAM 的关键区别
虽然都是片上缓存,但角色完全不同:
- SRAM (Shared Memory) 是程序员的”工作台”——你明确告诉 GPU 哪些数据要放进来共享、什么时候加载。FlashAttention 的 tile 就是显式塞进 SRAM 的。
- L2 Cache 是硬件的”自动缓存”——你管不了它存什么。但你能利用它的特性:如果连续两个算子读同一块 HBM 数据(比如
QK^T之后又要读S做 softmax),L2 可能让第二次读命中。
图解 L1、L2、SRAM
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!
10 分钟了解 SRAM、L1 Cache、L2 Cache
https://acoolfish.site/posts/sram-l1-l2-cache/相关文章智能推荐
1
GPU 架构与内存层级:SRAM、L2 与 FlashAttention 分块
GPU 与显存从 SRAM、Shared Memory、L2 Cache 到 HBM 的层级关系,以及 FlashAttention 如何用分块把显存复杂度从 O(N²) 压到 O(N)。
2
浅解 KV Cache 与 FlashAttention
LLM 推理KV Cache 解决"历史状态累积",FlashAttention 解决"单次计算的瞬时访存"——两堵显存墙的成因与解法。
3
浅解大模型训练中的数据格式与混合精度
训练基础FP16/BF16/FP8 的取舍、为什么 BF16 赢得训练而 FP16 退守推理,以及 AMP 混合精度训练的显存拆账。
4
浅解码码策略与投机解码
LLM 推理从 logits 到 token 的解码策略(Temperature / Top-K / Top-p)与投机解码的草稿-验证机制、接受概率公式与无损保证。
5
一个方程的四种解法:PPO / DPO / GRPO / GSPO
强化学习RLHF 的目标方程只有一行,PPO / DPO / GRPO / GSPO 是它的四种解法。从策略梯度、优势函数到重要性采样,一篇打通四个算法的共同骨架。
随机文章随机推荐